博文
pH-sensitive binder从头设计和新MPNN
||
国庆假期中,邮件提醒 Sergey Ovchinnikov 发了新论文,一种新的 MPNN —— Proton-PottsMPNN,不得不让笔者欣慰领域发展快,太好了终于有人把手伸向 pH-sensitive binder 的特异性模型了,而且还是特别靠谱的谢尔盖。
早在一年前,2025.9,David Baker 课题组就预印了《Computational design of pH-sensitive binders》;当然,我们不能遗漏 David Baker 课题组在 2019.5 发表于 Science 的《De novo design of tunable, pH-driven conformational changes》。
这两篇论文是数量稀少的,如果不是仅有的,pH-sensitive 蛋白的计算设计论文。
另一方面,业界对 pH-sensitive 抗体开发的需求是旺盛的。
举例而言,Satralizumab(Enspryng®)由日本中外制药(Chugai Pharmaceutical) 原创开发,并与罗氏(Roche) 合作完成后续的全球临床开发和商业化;靶向 IL-6R,能以pH依赖的方式与受体结合并在细胞内释放后重复利用,实现长效抑制;开发周期约7年,2020年8月批准上市,适应症为视神经脊髓炎谱系疾病(NMOSD)、甲状腺眼病(TED)。
Crovalimab (Piasky®/派圣凯®)同样由中外制药与罗氏合作开发;靶向补体C5,是一种长效再循环抗体,设计为在溶酶体中pH依赖性地释放C5,然后通过FcRn介导的途径回收;开发历时约7年9个月,2024年6月批准上市,适应症为阵发性睡眠性血红蛋白尿症(PNH)。
虽然 FDA 批准的 pH-sensitive 抗体仅有两种,但是有据可查的临床管线却有许多,我们不列举。总之,pH-sensitive 抗体或 ADC 等药物的开发方兴未艾。
然而,计算化学或者 AI 吧,在 pH-sensitive 抗体或 ADC 的开发中所能发挥的效用却很有限——因为计算工具或方法论很有限。
2019年的工作,我们姑且不论,因为前 AlphaFold2 时代的工作对启发我们在业务场景的应用帮助有限。2025年的预印本,我们有必要结合结合剂的 pH-sensitive 的原理简单介绍,为什么 binder 会对 pH 变化敏感?或者换一种问法,为什么 binder 会响应 pH 变化?
因为相当一部分AIDD 从业者不具备本科水平的理化生知识,而高中理化生知识可能太过遥远,我们回顾高中化学。
pH = -lg[H+],即氢离子浓度的以10为底的负对数。
pOH = -lg[OH-],即氢氧根离子的负对数。
pH + pOH = pKw,即水的离子积常数,离子积即氢离子浓度和氢氧根离子浓度的乘积,在25℃时等于14。所以,中性条件时,酸(氢离子浓度)和碱(氢氧根离子浓度)相等,pH = pOH = 7。
化学反应具有可逆性。酸 HA 在溶液中发生可逆解离:HA ⇌ H+ + A⁻。
高中化学学过勒夏特列原理——溶液中的 H+ 浓度增加(酸性增强),会使得平衡向左移动,抑制 HA 解离,溶液中 HA 浓度增加;相反地,溶液中的 H+ 浓度减少(酸性减弱),平衡右移,促进 HA 解离,溶液中 A- 浓度增加。
酸解离常数 Ka = [H+][A⁻] / [HA],从而 pKa = -lg Ka = pH - lg [A⁻] / [HA]。
所以:
当 pH < pKa 时,主要存在形式是质子化态 HA。
当 pH > pKa 时,主要存在形式是去质子化态 A⁻。
当 pH = pKa 时,两种形式各占一半。
氨基酸是一种酸,因为 -COOH 能解离 H+,也是一种碱,因为 -NH2 可以接纳 H+,同时氨基酸的侧链可能也具有接纳或解离 H+ 的能力。因此,如下图所示,根据氨基酸的不同质子化状态,有多个 pKa 值。对于蛋白质上的氨基酸残基,我们只考虑它的侧链。
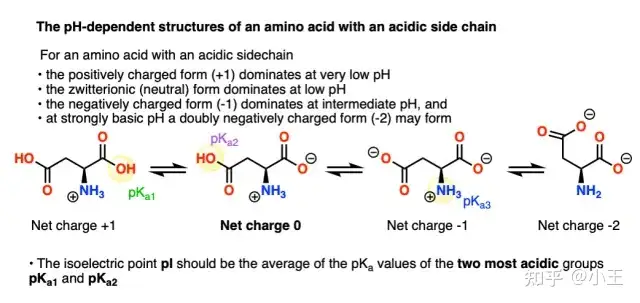
也就是说,在给定溶液酸性条件时(即给定 pH 值),pKa 值标定了氨基酸所处的质子化状态。
pH 是环境背景,是可以变化的,从接近酸中性的血液(pH 约 7.4)到酸性的内体、溶酶体(pH 4 - 6)或肿瘤微环境(pH 6 - 6.5),抗体分子在拥挤的分子溶液中经历了显著的、或许是连续的或许是阶跃的 pH 变化。
pKa 是具有特定序列和结构的抗体内各个残基所具有的内禀性质,构象不发生变化,那么 pKa 不变,通过调节构象,比如通过改变序列而影响折叠结构,则可能改变 pKa。
就此,我们举一个简单的例子。
假设 binder 上有一个 His,target 上有一个 Glu,二者形成contact,且这两个残基的 pKa 与其在理想水溶液中时一致(如下图)。那么,在血液中 pH = 7.4 时,His 基本电中性,Glu 去质子化(deprotonated)带负电荷。然而,当在微环境 pH = 4 时,环境酸性增强,H+ 浓度增加,His 质子化(protonated)带正电荷,而 Glu 则部分质子化(67% 不带电荷,33%带负电荷)。此时,二者可形成盐桥的比例增加,binder-target 的互作增强。
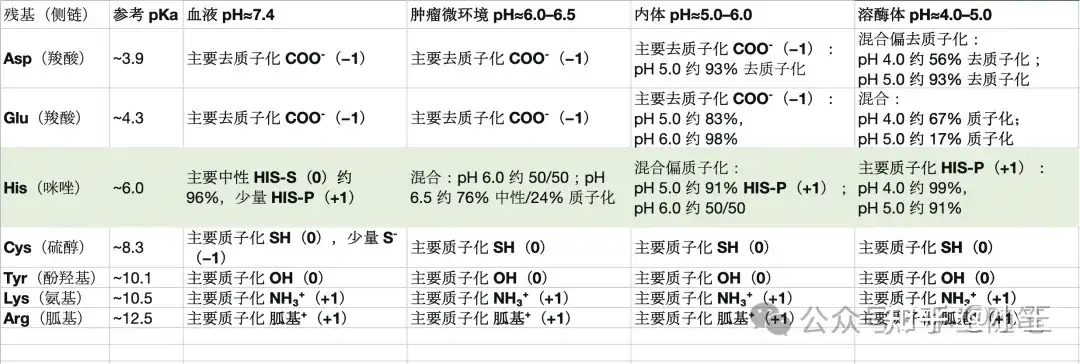
上面是一个过分简化的例子,因为残基的 pKa 的决定因素有很多。比如一种情况是,生理条件下(酸中性),围绕某个特定 His 存在一个氢键网络,那么 His 的质子化会会破坏这个氢键,使质子化态不稳定,因此为了使之质子化,就要环境 H+ 浓度更高才行 —— 因而该 His 的内禀 pKa 下移。
我们不一一列举。
要言之,理解环境背景和内禀性质,我们可以明白开发 pH-sensitive binder 的核心是:在目标 pH 附近,让处于关键位置的残基的质子化状态发生显著变化,并且这种变化直接导致结合增强或减弱。
因此,pH-sensitive binder 有两类,从中性到酸性环境:
增强结合 enhanced binding,
触发释放 triggered release。
基于上述原理,Baker Lab 预印于 2025.9 的工作采用了两个策略来调节关键位点的残基的 pKa:
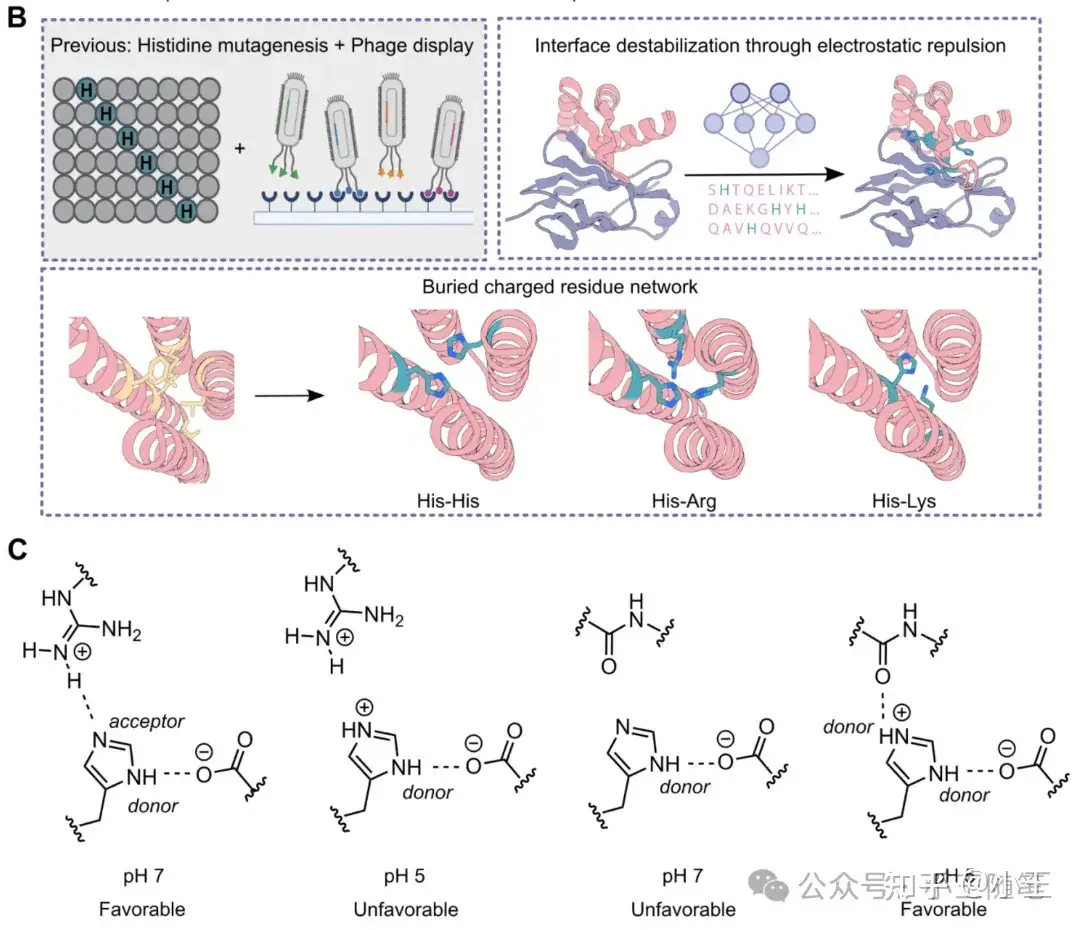
(1)界面组氨酸-正电荷排斥。在 binder–target 界面引入 His,并让它靠近靶标上的 Arg/Lys/His。酸性 pH 下 His 质子化带正电,与靶标正电荷产生静电排斥,同时失去氢键受体能力,导致结合减弱或解离。
(2)核心埋藏带电残基氢键网络。在 binder 核心安装 His–His、His–Arg、His–Lys 氢键网络。中性 pH 下网络稳定,binder 正常折叠;酸性 pH 下 His 质子化,正电荷之间排斥,破坏核心网络,使 binder 去稳定,加速解离。
这里,请注意,开发 pH-sensitive binder 未必只能从binder表位着手,还可以检索其结构核心所包埋的含带电残基的氢键网络。不过,对于抗体开发而言,因为主要的设计区域集中于 CDR,所以,pH-sensitive antibody 开发主要采用策略一。
在工作流上,作者先使用 RFDiffusion2 采样 binder 骨架,再结合 AlphaFold2 + ProteinMPNN 设计序列并过滤,而后用 Rosetta 筛选,得到初识的从头设计 binder。
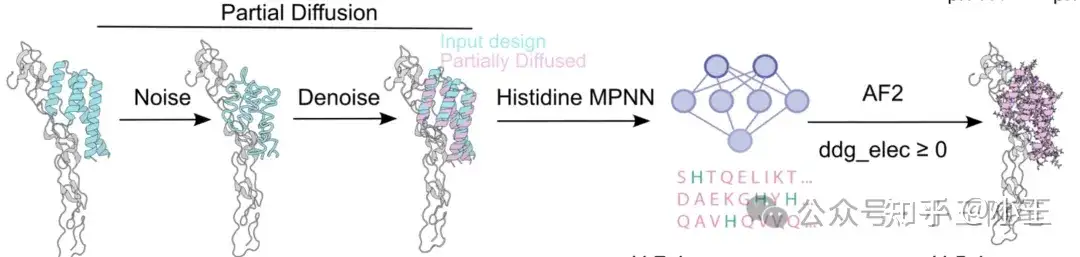
针对策略一,作者在初始 binder 的骨架上,针对交界面做 partial diffusion,利用 ProteinMPNN 增加交界面出现 His 的权重采样序列,而后用 Rosetta pH module 筛选。(下图)
针对策略二,作者在初始binder的骨架上,搜索包埋在结构核心的 His-His/Arg/Lys 氢键,围绕该氢键用 Rosetta FastDesign biased by ProteinMPNN 重设计 His 周围区域。(下图)
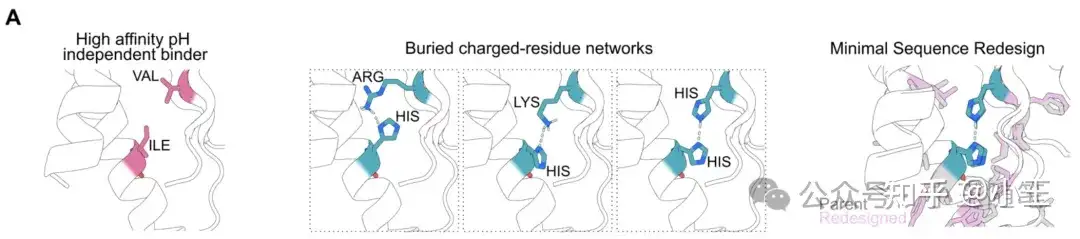
总结起来,这篇工作中,残基的质子化态不进入序列设计模型,而是基于 Rosetta 物理规则,在已有 binder 上实现 His 界面排斥或埋藏带电氢键网络;目标是中性结合、酸性解离。
简单地讲,RFDiffusion2、ProteinMPNN、AF2 等工具不知道其所面对的蛋白质的序列或者结构中的各个残基处于什么质子状态,作者依赖物理理解,基于 Rosetta,围绕位于交界面的 His 或者位于包埋核心的 His-His/Arg/Lys 氢键,进行骨架结构和序列的采样,并且基于 Rosetta 完成计算筛选。—— pH 敏感性是事后筛选,不是设计时直接指定。
为什么不把质子化状态写入模型,绕过 Rosetta,直接设计呢?
这就是 David Baker 的高徒谢尔盖的 Proto-PottsMPNN 所做的。
Proton-PottsMPNN 是 PottsMPNN 的质子化状态显式版:把 His、Asp、Glu 的质子化/去质子化状态当成独立的 sequence token,用一个共享 backbone encoder + autoregressive decoder + Potts energy head 来同时设计序列和“偏好哪种质子化状态”。
这样就能把 pH-sensitive binder 设计成 two-state design:固定某些残基为目标质子化态,重设计周围环境,使目标态比替代态能量更低,从而实现“酸性条件下结合/释放”的开关。
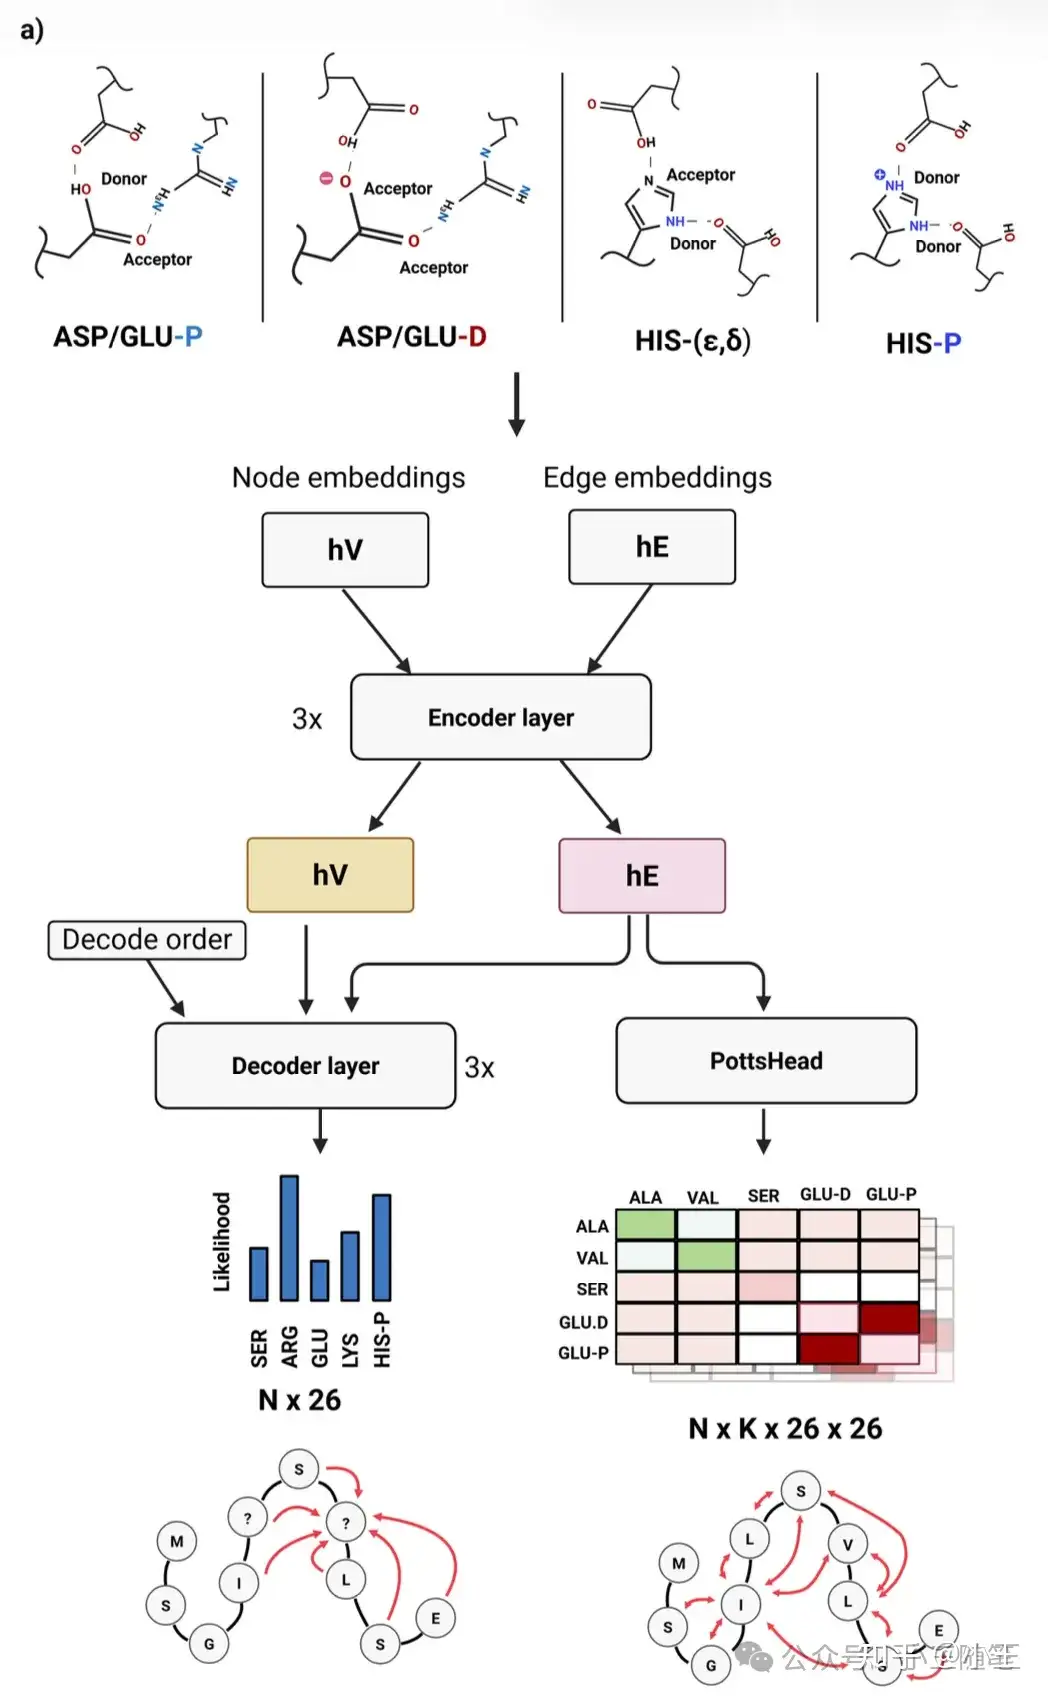
训练数据是什么?数据驱动的蛋白质药物分子开发,所谓AIDD,最大的限制条件从来都是有标签数据的稀缺。pH-sensitive 抗体的开发更是如此。酸中性条件下的开源的亲和力数据尚且贫乏,遑论不同 pH 值下的。
当然,不必过分发散,为了训练含显式的质子化状态的模型,则需要残基的质子化状态标签。作者从 PDB 中总共获得了 216 个结构、7,434 个带标签残基:
HIS-P(阳离子 imidazolium,+1):416
HIS-S(单质子化中性咪唑):804
ASP-P(中性质子化羧酸,COOH):36
ASP-D(去质子化阴离子羧酸,COO⁻):3,164
GLU-P(中性质子化羧酸,COOH):58
GLU-D(去质子化阴离子羧酸,COO⁻):2,956
显然,数据不仅少,比如 ASP-P 仅有36个 —— 在 PDB 的20余万结构中仅有36个有标签的 ASP-P 残基;而且,数据很不平衡,ASP-D / GLU-D 显著多于 ASP-P / GLU-P。
为此,作者训练了一个 XGBoost 分类器,将之应用于 PDB 库中不含残基质子化状态标签的结构以及 AFDB,将数量最少的 ASP-P / GLU-P 都扩展到大几十万量级。而后,基于扩展数据集,训练 Proton-PottsMPNN。
作者以 PD-L1 作为靶点,设计 pH-sensitive binder,其先利用 RFDiffusion3 + ProteinMPNN + RF3 设计获得种子 binder,然后使用 Proton-PottsMPNN 执行两步工作流改造种子序列:(1)选择一个或多个可滴定中心,将之固定为目标质子化态 token(比如目标是在酸性时HIS 成为 HIS-P);(2)围绕每个被固定的可滴定中心,重新设计其周围残基,同时优化:设计的全局 Potts 能量,和目标质子化态与其替代态之间的能量差。
简评。
1、Baker 的 2025.9 的工作有显然的局限性。
其工作流中的设计模型本身没有显式表示质子化状态。虽然 ProteinMPNN 可以通过组成偏好增加 His,但不能区分阳离子型 His 和中性 His;质子化只在设计完成之后,通过 Rosetta 中“所有 His 都双质子化”的 pose 进入打分,再用氢键和静电过滤器筛选。
因此,候选序列是“被筛选”为 pH-sensitive,而不是“被设计”为 pH-sensitive;并且,决定可滴定残基 pKa 的局部环境不能被直接调控;更重要地,pH 开关基本局限于 His。
2、谢尔盖的 2026.9 的工作相较而言,很生动地向学习者展示了,学科细分领域的前沿方法论的进化:
经验筛选 --> 理性设计,早期靠 His 扫描加展示,现在靠 de novo 设计加能量模型。
隐式质子化 --> 显式质子化,质子化从 Rosetta 事后过滤,变成序列设计中的显式 token。
单一 His --> 多可滴定残基,开关残基从 His 扩展到 Asp、Glu,利用埋藏羧酸 pKa 上移和电荷排斥机制。
酸解离 --> 算解离 / 酸结合,Baker 工作主要实现中性结合、酸性解离;Proton-PottsMPNN 则进一步支持酸性结合、中性释放,并试图统一优化稳定性和选择性。
3、下一步呢?
虽然事情起了变化,但是前路依然是曲折的。Proton-PottsMPNN 预印本的不足,读者大可让 deepseek 给出审稿意见,和潜在拓展方向,并据此卷一卷和水一水。
如果我有足够的资源,我想在纯应用层面,先试试这样几件事:
利用 Proton-PottsMPNN,设计靶向 PD-L1 的 VHH(而不是miniprotein),验证模型效果;
利用 Proton-PottsMPNN,设计靶向其它靶点的 minibinder,验证模型能效果;
利用 Claude Science 自动化设计 binder 的提示词,结合 Proton-PottsMPNN,自动化设计 minibinder / VHH,观察效果。
这几件小事没有科学创新性。我在之前的短文中分享过观点,目前蛋白质设计领域的学界开源模型的上界,决定了 agentic auto research 的上界。(见《对Claude“炸场”蛋白从头设计的几点思考》)
因此,我关心的是,对于 pH-sensitive 抗体的开发,我们可以多大程度上抛弃人 / AIDD 平台。
本文完。
2026重阳节于上海
https://blog.sciencenet.cn/blog-3458695-1557329.html
上一篇:Claude发现新CRISPR系统的科研自主性有多高?

