博文
Claude发现新CRISPR系统的科研自主性有多高?
||
2026.9.23,A家又发表了一篇利用Claude Science完成的工作 —— 使用约 950 个 Claude Mythos 5 智能体并行工作 21.5 小时,消耗 2.1 亿词元,从超过 20 万个逆转录酶(RT)序列中筛选出类 CRISPR 系统。
预印本论文(PDF 原文)https://www-cdn.anthropic.com/22573675ada52a8ca8a97a1a4b4326b2f208a071.pdf
Anthropic 官方公告https://www.anthropic.com/news/claude-discovers-novel-enzyme-system
在过往,我介绍过很多蛋白质挖掘的具体手段,如下:
因此,我这里,不讨论A家如何挖掘新酶。粗略看来,Claude 在这项工作中所展现的水平低于 Jennifer Doudna、张锋、高彩霞等课题组的平均水平。
值得一提,这项工作6位作者中的4位:一作、二作和两位通讯作者都是在顶尖基因编辑实验室受过训练且有顶刊发表经历的博士。比如,最后通讯作者 Matthew G. Durrant 是斯坦福大学的遗传学博士(2020),在Arc研究所完成了3年博后训练,作为主要作者发表了EVO(共一第三)和EVO2(共一第二)。所以,我们可以认为这篇工作在 human-in-the-loop 方面已经做到了最佳。
我简单地考察A家的研究员是怎么用 AI agents 的——如何在科学家的监督和控制下让AI agents 展现自主性和智能性。
一、人做了什么,AI做了什么?人的作用可以概括为:
运行前:设定初始“研究brief”(research brief)、选测试案例、制定参考 RT(逆转录酶)、建 harness 和数据库;
运行中:无人类干预;
运行后:以交互式Claude Science会话指导后续分析、设计可重复性实验、执行湿实验、设计基准与评分、命名、写作、同行审阅;
最终判断:实验验证和生物学解释仍由人类科学家负责。
论文中,作者多次提到 “Supplementary Note 1” —— 研究 brief,其包含了规定了整个自主基因组挖掘 campaign 的目标和阶段,但是它却没有被包含在公开的PDF中,似乎也无处下载。我写了邮件给通讯作者,没有得到回应。
因此,我们可能还是要等待一段时间才能完整地看清这项工作中人做了什么,AI 做了什么。
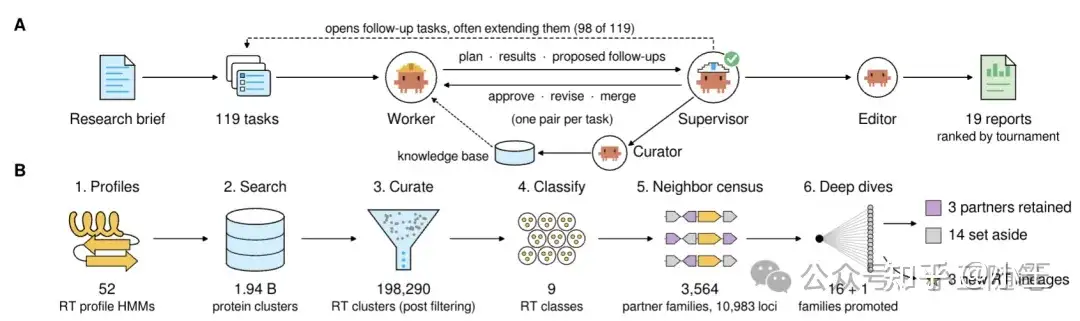
论文图1。
Claude 完成了全部计算分析,包括自主搜索、筛选、识别异常、分析、生成报告。—— 也就是论文图1A、B(上图)所示的所有工作。
作者使用 Harness,其把一份人类写的研究 brief 转化为一系列可执行的分析阶段和任务,并调度多个 Claude 智能体自主完成从数据扫描到报告撰写的全过程。每个智能体都是 Claude Code 实例,配置为 Claude Mythos 5 模型。
二、Harness 的架构 / agent 角色分工这项工作的自主研究 Harness 包含5 种不同角色的 agent:
Launch agent,编码链式分析工作流;
Worker,计划/执行/提交;
Supervisor,审查/接受或修订;
Curator,录入共享知识库;
Editor,审查报告。
Launch agent 首先把“研究 brief”转换成一系列分析阶段(即研究步骤),例如扫描数据库寻找同源物。每个阶段又拆成更小的任务。我理解 Launch agent 相当于整个程序的主函数。
这些阶段遵循五阶段链式流程(如下),其之间有严格顺序:前一阶段的任务未完成,则后一阶段的任务不会打开。每个阶段由脚本化的完成检查关闭。
五阶段链式流程:
Input assembly(输入组装),
Database sweep(数据库扫描),
RT classification(RT 分类),
Neighborhood census(邻域普查),
Deep dives(深度调查)。
每个任务分配一个 Worker。Worker 先写出计划,执行计划,然后提交书面总结、代码和数据文件。
接着,Supervisor 审查 Worker 的计划、总结和编辑后的文件,决定接受还是退回修改。
Worker 在工作过程中可以提出 follow-up 任务。这些任务进入分诊队列(triage queue),由 Supervisor 决定释放或拒绝,并给出书面理由。Supervisor 也可以根据观察打开新任务,交给新的 Worker,让 campaign 随着发现积累而自我扩展。——所谓“deep dive”。
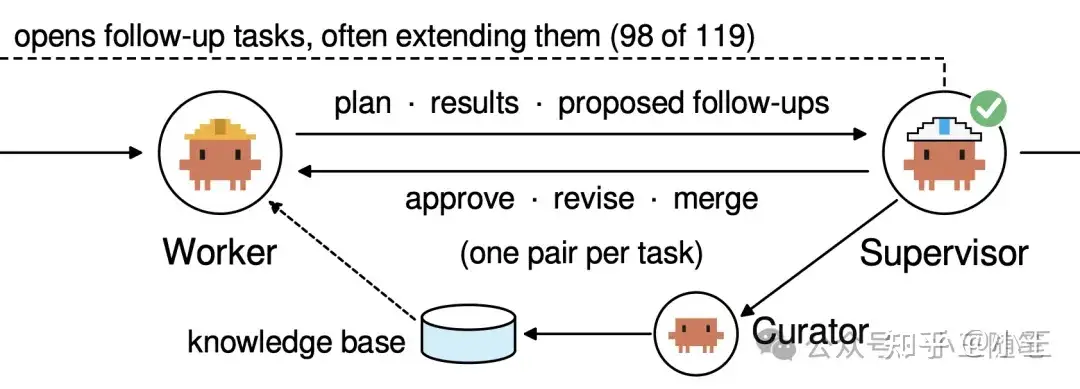
每个任务完成后,Curator 阅读 task brief 和 Worker 的总结,并把发现录入共享知识库。相关条目会被包含进后续 Worker 和 Supervisor 的提示词中。所有计划、结果、审查和脚本都提交到版本控制的共享记录,每个 agent 都可读。——也就说,所有任务的记忆是被所有 agent 共享的。
最后,Editor 审查归档之前的报告。当没有可派发的任务时,campaign 结束。最终发现以书面报告形式交付给人。
整个 campaign 运行了 949 个会话(session),包括:
1 个 launch 会话 —— 运行一次主函数,
414 个 worker 会话,
375 个 supervisor 会话,
107 个 curator 会话,
52 个 editor 会话。
前面已经说过,五阶段链式流程包含:输入组装、数据库扫描、RT 分类、邻域普查,和第5步 deep dive。
前四步完成后,agents 已经从约 19 亿个蛋白质簇中回收了约 20 万个 RT 簇,分类为 9 个 RT 类别,并采样了约 11,000 个 RT 位点。邻域普查对 3,564 个反复出现的邻近蛋白家族进行评分,最终有 17 个候选伴侣家族被推入 deep dive。下图是论文图1B、C的一部分,展示了其中发现 ART 的 deep dive。
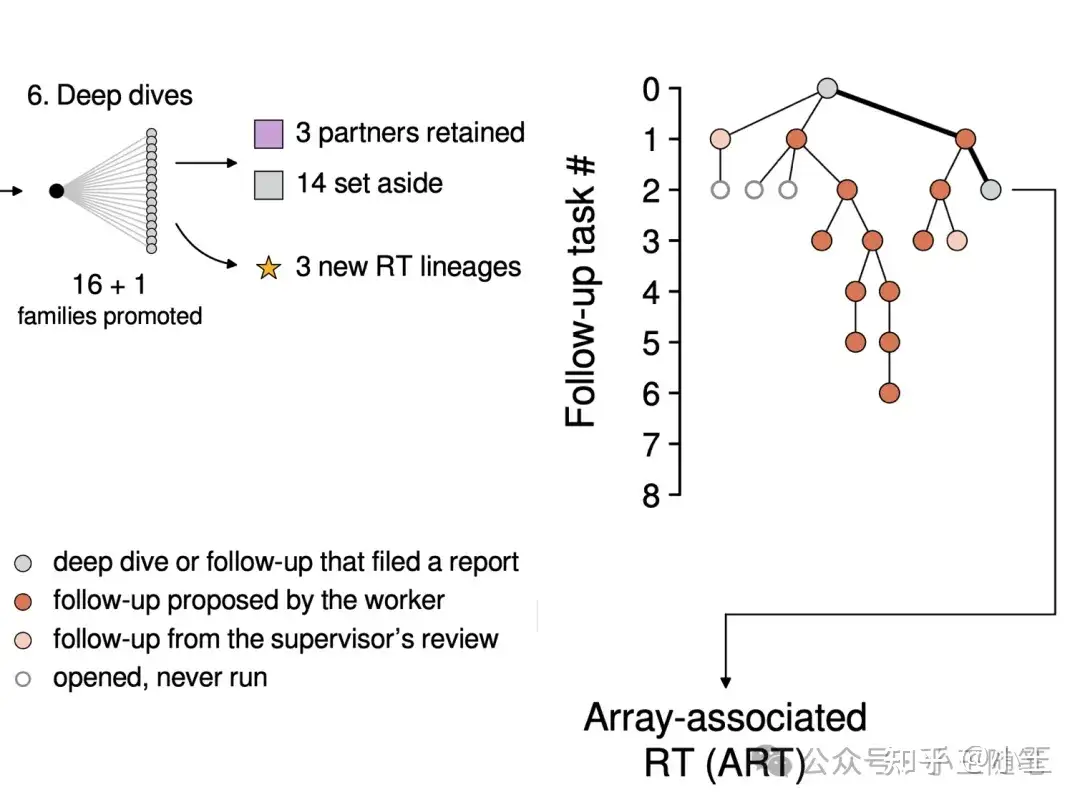
Deep dive 体现了本项工作中 AI 的自主性:Worker 从自身知识中产生预期——根据前一个任务的结果以及之前所有其它 agents 所共享的记忆,而后判断异常观察值是否值得进一步追踪,提出 follow-up 新任务,扩展调查范围。此过程中,多智能体协作:Worker、Supervisor、Curator、Editor 共同参与。
值得强调,在以往的科学发现自动化中,结果预期和新颖性判断通常由人完成。
也就是说,这里的 AI 部分地代替了人。
之所以说“部分”,是因为 Harness 虽然观察到了异常,但是在目前仍然是一种很弱的观察——在10次 campaign中只成功了一次。
四、可以 human-off-the-loop 吗?我认为,这等同于问,此项工作中的 Harness 可以更自主一些吗,以至于无需人在分析中与之交互?
论文的讨论有一段有意思的话——作者讨论什么是异常(anomaly)。
我们知道,科学发现往往来自于实验中的异常,不期而遇的异常。“不期”点题。不符合期望的才是异常。我们在制定研究方案时,必须要有期望和假设。期望的来源却不一定相同。那么,期望是什么呢?
此项工作的作者们讨论:对统计学家,预期是数据的一个显式模型,一种对数据的统计模式的理解;对生物学家,预期常来自语境和默会知识。
For statisticians that expectation is an explicit model of the data, whereas for biologists that expectation is often derived from contextual and tacit knowledge. (Yoon et al., 2026)
我们看到,agents 在 campaign 中已经能提供预期和新颖性判断 —— 这是基于统计的和已有学术论文的,但在 campaign 后的分析方向,依然需要人——人的“常来自语境和默会知识”的专家经验。
本文完。
2026国庆节于上海
https://blog.sciencenet.cn/blog-3458695-1554980.html
上一篇:对Claude涉足蛋白从头设计的几点思考

