博文
对Claude涉足蛋白从头设计的几点思考
||
2026.8.18,Claude Science 在线预印了一篇自动化从头设计结合蛋白的论文。引人注意的是,Claude Science在这篇论文中开放了所有结果的下载权限,并且将长达1.6万词的提示词也全部公开了。
这篇预印论文的科学意义上的新意非常有限,只因为是由 Claude Science 做的,且有“自动化”、“agent”等标签,所以值得一些讨论。
我粗略地阅读了全文和提示词,提几点思考,抛砖引玉。
1、文章没有消融实验A家(即Anthropic)很慷慨地将所有提示词都开源了,多达1.6万词,分三大模块、15个子块(见下图)。提示词的解读,我想,有心人自然可以用任何一种主流的 LLM 去做,详细地拆解各个模块,精准地一字不漏地翻译文本。我们不赘述 —— 大语言模型时代,关心的人自己会去做,不关心的人又何必读呢?
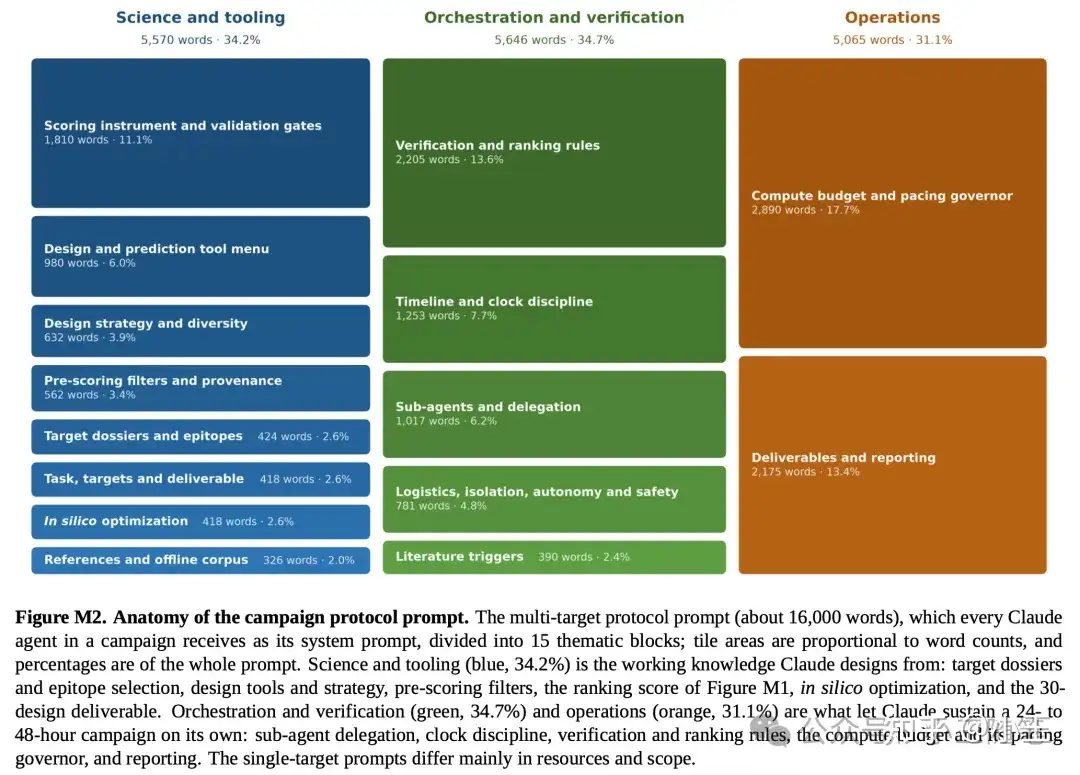
我好奇,并提请大家思考的是:A家的这份提示词是怎么写出来的?论文没有回答。
或者我们换一种问法:A家的这份提示词的“底层逻辑”是什么?
当然,考虑到 Claude 的基模能力,完全可以直接问 Claude:我想用Claude完成结合蛋白的自动化从头设计,请给我生成一份提示词。或者,我想用 Claude 完成结合蛋白的自动化从头设计,我需要考虑哪些因素 / 我应该怎么问你,以获得一份提示词?
然后经过几轮交互获得提示词的最终形态。——我的问题在于,如果A家的研究员确实是这么做的,他们怎么和 Claude “交互”的,所谓“底层逻辑”。能够使用 Claude 的本文的读者当然可以自己试一试,只需要限定网络资源搜索时间在8.18之前。
思考“A家的这份提示词是怎么写出来的”本质因为我们想知道:这份提示词能进一步优化吗?—— A家没有对提示词做消融实验。
比如,如果去掉“流程编排”模块(34.7%),Claude 是否还能保持24-48小时的自主运行?
如果去掉“预算调控器”(BUDGET),是否会超支或算力不足?
如果要求每个靶点生成10万而非100万设计,结果会怎样?
不同版本的 Claude(Opus 4.8 vs Mythos Preview)在相同提示词下的表现差异,有多少来自模型本身,多少来自单次运行的随机性?
等等。
我们可以很容易想到,提示词的消融,可以有多个层级:
(1)模块级消融。逐一移除 Figure M2 中三大模块的各个子模块,观察命中率、排名精度、预算利用率等指标的变化。比如,移除“文献触发机制(Literature triggers, 390 words, 2.4%)”,验证任务失败时所触发的“重读论文”是否提升鲁棒性。
(2)提示词结构消融。不减少模块,而将16,000词提示词压缩为5,000词,观察是否性能下降;或者将提示词拆分为多个独立提示词(而非一个统一系统提示词),观察智能体协调是否受影响。
(3)工具级消融。不减少模块也不压缩提示词,逐一移除或替换某个结构生成工具或序列设计工具,观察其对最终命中率的贡献。比如,只用 RFdiffusion,不允许多工具切换,会影响命中率吗?
(4)参数级消融。对关键参数进行网格搜索或随机搜索。比如,当前论文所使用的 ipSAE:sc_DockQ 权重 = 4:1,那么测试1:1、2:1、8:1、纯ipSAE、纯DockQ。
这里多说一句,这篇论文“只”用了2个打分指标(ipSAE 和 sc_DockQ)来过滤生成的分子,ipSAE 是对 ipTM 所做的物理意义非常清晰的改进,见AlphaFold复合体预测结构度量的缺陷和改进。
(5)语料库消融。去除关键离线语料,如曹龙兴的著名的前 AlphaFold2 时代的结合蛋白从头设计 Nature 论文(Cao et al., 2022),会影响命中率吗?
有消融,才有优化。相信读过 Jumper 在离职 DeepMind 后接受的播客访谈的人都会对其强调消融实验印象深刻。
上述(5)引出我们的第二点思考。
2、离线语料库“References and offline corpus” 包含了哪些内容,起什么用?同样地,“离线语料库包含哪些内容、怎么用”,我们不赘述,有心人自己问LLM。
我们可以注意到,离线语料库不仅纳入了前 AlphaFold2 或者 RFDiffusion 时代的、基于物理的从头设计论文Cao et al., 2022,而且还将这篇论文的 SI 和 reporting summary 纳入;对于BindCraft论文,离线语料库则进一步加入了peer review。
这让我们思考,为了让基模有足够的 biological insight,我们究竟要在语料库中加入多少内容,并通过提示词让之在通用流程失败未能达到期待的命中率时阅读索引?
这恐怕等同于问:为了成功设计,需要哪些“专家经验/技能”,所谓 expert skills?专家会在什么情况下去查询哪些资料?
这引出第三点思考。
3、没有专家经验怎么办?本质上,结合蛋白的从头设计是一个相对而言被充分研究的课题,然而不同靶点的研究程度时迥然的。低垂的果实被反复摘取,而高耸的靶标则罕有成功。
这导致,显然地,一些靶点有丰富的成功设计策略,而一些靶点则无。A家论文也明显如此——尽管15个靶点的总成功率可被说为“近40%”,并且一些靶点(如PD-L1)的命中率高达90%,但是依然有4个靶点的命中率是个位数的(见下图)。
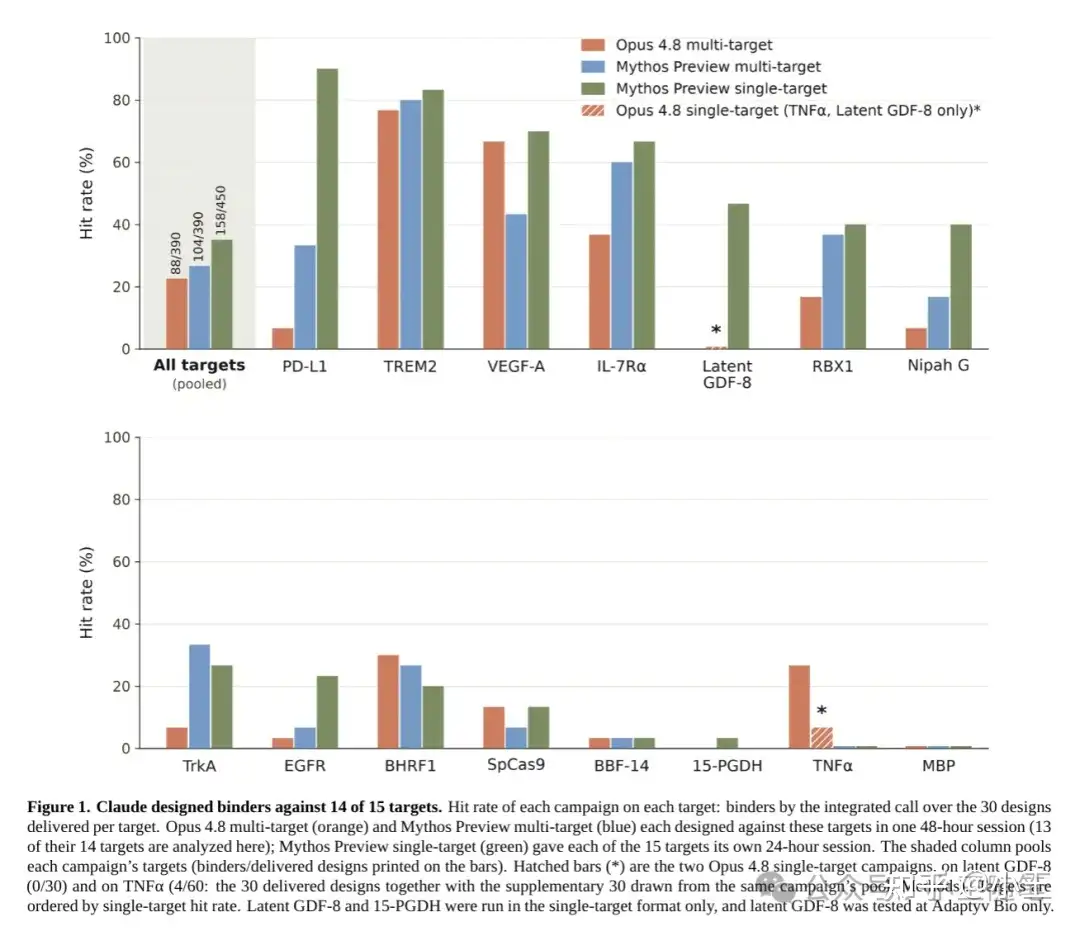
面对论文的结果,我们自然可以问,诸如 BBF-14 这样命中率低于10%的靶点,是因为离线语料中的从头设计论文不够,还是结构生物学论文不够,抑或是生物物理学论文(比如折叠机制)不够?
由此,我们也可以看出,为什么我在开头即说,A家的这篇自动化从头设计论文的科学新意非常有限 —— 因为原本科学家做不到的事,Claude 还是做不到啊!
当然,批判归批判,赞扬也要赞扬。这篇工作的工程化意义很强 —— 引出第4点。
4、这篇工作对“AI制药”的概念有冲击现在,假设你是 biopharma,要做AI转型,怎么选:
(1)购买AI制药 biotech 公司的SaaS服务。
(2)招3个人,1个软件工程师有 LLM 和 Agent 的部署开发经验,1个计算化学家能理解计算化学结果,1个药物化学实验学家(如抗体科学家)有药物分子的合成表征经验且对行业专利敏感。这三人 —— 软件工程师部署 LLM 测试模型,计算化学家和抗体科学家准备离线语料,包括专利(这是 Claude 这篇论文所不含的),计算化学家执行计算提交且阶段性控制和解读计算结果(不做全流程自动化,而设置 check point),抗体科学家检查并决定实验送测。
当然,(2)可能是过分简化的团队模型,不过所有重装的SaaS服务是不是依然变得不那么必要了?
而人,推动历史的人,变得更重要了。
本质上,问题在于:完全的黑箱的计算过程对“制药”而言是可以接受的吗?
本文完。
2026.9.5于上海
https://blog.sciencenet.cn/blog-3458695-1551180.html
上一篇:Jumper离职DeepMind,AlphaFold时间线告一段落

